AI 에이전트를 공부하다 보면 헷갈리는 개념이 하나 있습니다.
“AI가 이전 내용을 기억하는 것과 RAG는 같은 것 아닌가?”
겉으로 보면 비슷해 보이지만 실제로는 목적이 다릅니다.
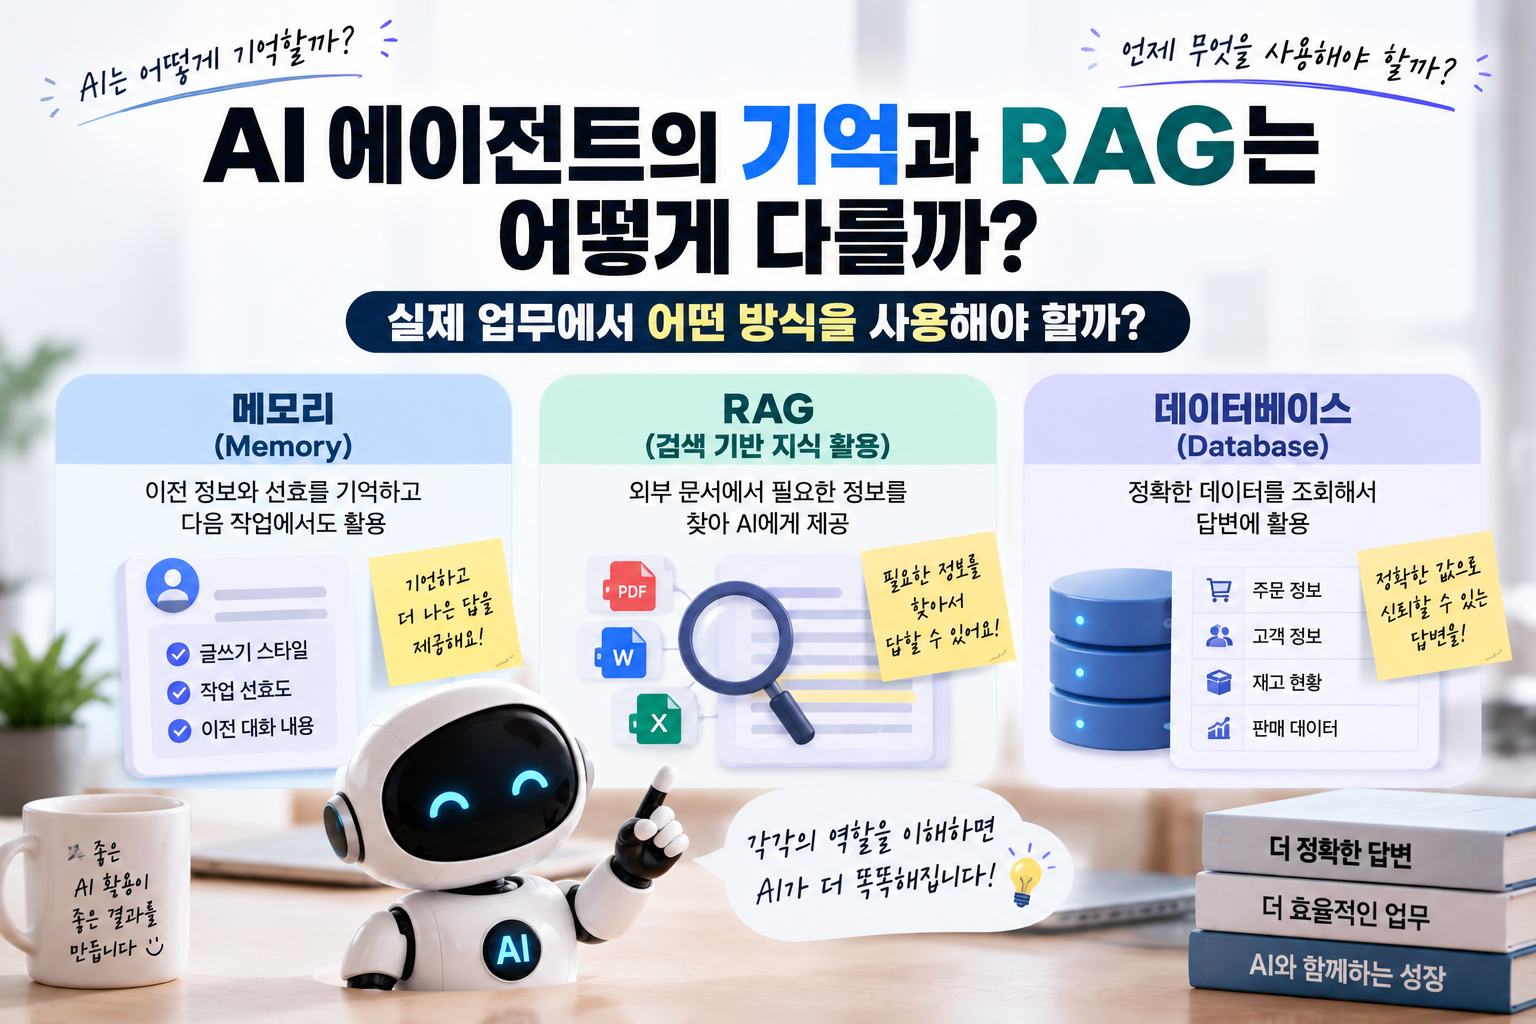
예를 들어 AI에게 “나는 글을 작성할 때 너무 딱딱한 문체를 좋아하지 않아”라고 알려주고 다음 작업에서도 이 취향을 반영한다면 ‘기억’에 가까운 개념입니다.
반면 “우리 회사의 업무 매뉴얼에서 환불 조건을 찾아줘”라고 했을 때 수많은 문서에서 관련 내용을 검색해서 답변하도록 한다면 RAG에 가깝습니다.
이 둘의 차이를 이해하면 AI 자동화를 설계할 때 불필요하게 복잡한 구조를 만드는 것을 줄일 수 있습니다.
- AI의 기억은 무엇일까?
AI의 기억은 쉽게 말해 이전에 알게 된 정보나 작업 상태를 다음 작업에서도 활용하는 것입니다.
예를 들어 콘텐츠 제작을 도와주는 AI가 있다고 해보겠습니다.
처음에 사용자가
“나는 제목을 짧게 만들고, 본문은 초보자도 이해하기 쉽게 작성하는 것을 선호해.”
라고 알려줬습니다.
이후 새로운 글을 작성할 때도 이 정보를 활용한다면 사용자의 선호를 지속적으로 활용하는 구조라고 볼 수 있습니다.
또 이전 작업에서 어디까지 진행했는지, 어떤 설정을 사용했는지 등을 다음 작업에서 활용하는 것도 기억의 한 형태로 생각할 수 있습니다.
핵심은 ‘과거의 정보나 상태를 활용한다’는 것입니다.
- RAG는 기억이 아니라 ‘검색’에 가깝다
RAG는 Retrieval-Augmented Generation의 약자입니다.
어렵게 생각할 필요 없이
“필요한 정보를 외부 자료에서 찾아서 AI에게 제공하는 방식”
이라고 생각하면 됩니다.
예를 들어 회사에 다음과 같은 자료가 있다고 가정해보겠습니다.
- 제품 설명서
- 고객 응대 매뉴얼
- 환불 정책
- 배송 규정
- 직원 교육자료
AI에게 모든 문서를 매번 입력하는 대신 문서를 저장해두고 질문이 들어오면 관련된 내용을 검색합니다.
그 결과를 AI에게 전달하고 답변을 생성하도록 하는 것입니다.
전체 문서
→ 필요한 정보 검색
→ 관련 내용 전달
→ AI 답변
이것이 기본적인 RAG 구조입니다.
Anthropic 역시 RAG를 외부 지식에서 관련 정보를 검색한 뒤 그 내용을 모델의 입력에 추가해 답변을 생성하는 방식으로 설명하고 있습니다. (anthropic.com)
- 그렇다면 데이터베이스는 어디에 해당할까?
여기서 데이터베이스까지 등장하면 더 헷갈릴 수 있습니다.
하지만 데이터베이스는 역할이 조금 다릅니다.
예를 들어 쇼핑몰에서 다음과 같은 정보가 있다고 해보겠습니다.
- 주문번호
- 고객번호
- 상품명
- 주문일
- 결제금액
- 배송상태
- 재고수량
이런 정보는 정확하게 저장하고 조회해야 합니다.
“주문번호 12345의 배송 상태가 뭐야?”
라고 질문한다면 데이터베이스에서 정확한 값을 가져오는 것이 적합합니다.
굳이 수백 개의 문서를 검색하는 RAG를 사용할 필요가 없는 것입니다.
- 메모리·RAG·데이터베이스 비교
세 가지를 한 번에 비교하면 훨씬 쉽게 이해할 수 있습니다.
| 구분 | 메모리 | RAG | 데이터베이스 |
|---|---|---|---|
| 핵심 역할 | 과거 정보·상태 활용 | 외부 자료 검색 | 정확한 데이터 조회 |
| 주로 다루는 정보 | 사용자 선호, 이전 작업 | 문서, 매뉴얼, 자료 | 주문, 가격, 수량, 상태 |
| 핵심 질문 | “전에 무엇을 알고 있었지?” | “필요한 정보가 어디 있지?” | “정확한 값이 뭐지?” |
| 대표적인 예 | 글쓰기 스타일 기억 | 환불 규정 검색 | 주문 배송상태 조회 |
| 적합한 상황 | 개인화·연속 작업 | 많은 문서 활용 | 구조화된 데이터 처리 |
| 주의할 점 | 불필요한 정보 저장 | 검색 결과의 정확성 | 데이터 최신성·정확성 |
이 표에서 가장 중요한 것은 세 가지가 서로 경쟁하는 기술이 아니라는 점입니다.
오히려 하나의 AI 에이전트 안에서 함께 사용할 수도 있습니다.
- 실제 업무에서는 세 가지를 함께 사용할 수 있다
예를 들어 고객 상담 AI를 생각해보겠습니다.
고객의 과거 상담 내용과 선호 방식은 메모리를 통해 활용할 수 있습니다.
현재 환불 정책은 회사의 문서에서 RAG를 이용해 검색할 수 있습니다.
그리고 고객의 주문번호와 배송 상태는 데이터베이스에서 정확하게 조회할 수 있습니다.
구조를 단순하게 표현하면 다음과 같습니다.
고객 정보
+
과거 상담 내용
+
회사 정책 검색
+
주문 데이터 조회
↓
AI
↓
상황에 맞는 답변
이처럼 각각의 역할을 나누면 AI가 필요한 정보를 더 적절한 방식으로 활용할 수 있습니다.
- RAG가 있다고 해서 AI가 항상 정확한 것은 아니다
여기서 한 가지 주의할 점이 있습니다.
RAG를 사용한다고 해서 AI의 모든 답변이 자동으로 정확해지는 것은 아닙니다.
검색 과정에서 잘못된 문서를 가져올 수도 있기 때문입니다.
예를 들어 1,000개의 문서가 저장되어 있는데 질문과 관련성이 낮은 자료가 검색된다면 AI는 잘못된 자료를 바탕으로 답변할 수 있습니다.
또 문서를 너무 작은 단위로 나누면 중요한 문맥이 사라질 수도 있습니다.
Anthropic도 이러한 문제를 개선하기 위해 검색된 정보에 문맥을 추가하는 Contextual Retrieval 방법을 소개하고 있습니다. (anthropic.com)
따라서 RAG의 핵심은 단순히 문서를 많이 넣는 것이 아닙니다.
어떤 자료를 넣을 것인지,
어떻게 나눌 것인지,
어떤 정보를 검색할 것인지,
검색 결과가 실제 질문과 관련 있는지를 함께 관리해야 합니다.
- 실제로 어떤 것을 선택해야 할까?
복잡한 기술 용어를 모두 기억할 필요는 없습니다.
다음 네 가지 질문만 생각해보면 됩니다.
“사용자의 과거 정보나 선호를 계속 활용해야 하는가?”
→ 메모리
“많은 문서에서 필요한 내용을 찾아야 하는가?”
→ RAG
“정확한 숫자나 상태를 조회해야 하는가?”
→ 데이터베이스
“외부 서비스를 실제로 조작해야 하는가?”
→ API 또는 도구 연동
이 기준만 기억해도 AI 자동화를 설계할 때 방향을 잡기가 훨씬 쉬워집니다.
마무리
AI 에이전트의 메모리와 RAG는 비슷해 보이지만 해결하려는 문제가 다릅니다.
메모리는
“전에 무엇을 알고 있었지?”
에 가깝고,
RAG는
“지금 필요한 정보가 어디에 있지?”
에 가깝습니다.
그리고 데이터베이스는
“정확한 값이 무엇이지?”
를 확인하는 데 적합합니다.
정리하면 다음과 같습니다.
메모리 → 과거 정보와 상태
RAG → 외부 문서와 지식 검색
데이터베이스 → 구조화된 데이터 조회
API·도구 → 실제 업무 실행
결국 AI 자동화에서 중요한 것은 가장 많은 기술을 사용하는 것이 아닙니다.
내가 처리하려는 정보의 성격을 먼저 파악하고, 그에 맞는 방법을 선택하는 것이 더 중요합니다.
처음 AI 자동화를 시작한다면 “어떤 최신 기술을 붙일까?”보다 먼저
“내가 필요한 정보는 무엇이고, 그 정보는 어디에 있어야 가장 정확하게 사용할 수 있을까?”
라는 질문부터 해보는 것을 추천합니다.
참고 자료
Anthropic, Contextual Retrieval
Google Search Central, Creating Helpful, Reliable, People-First Content
Model Context Protocol 공식 문서