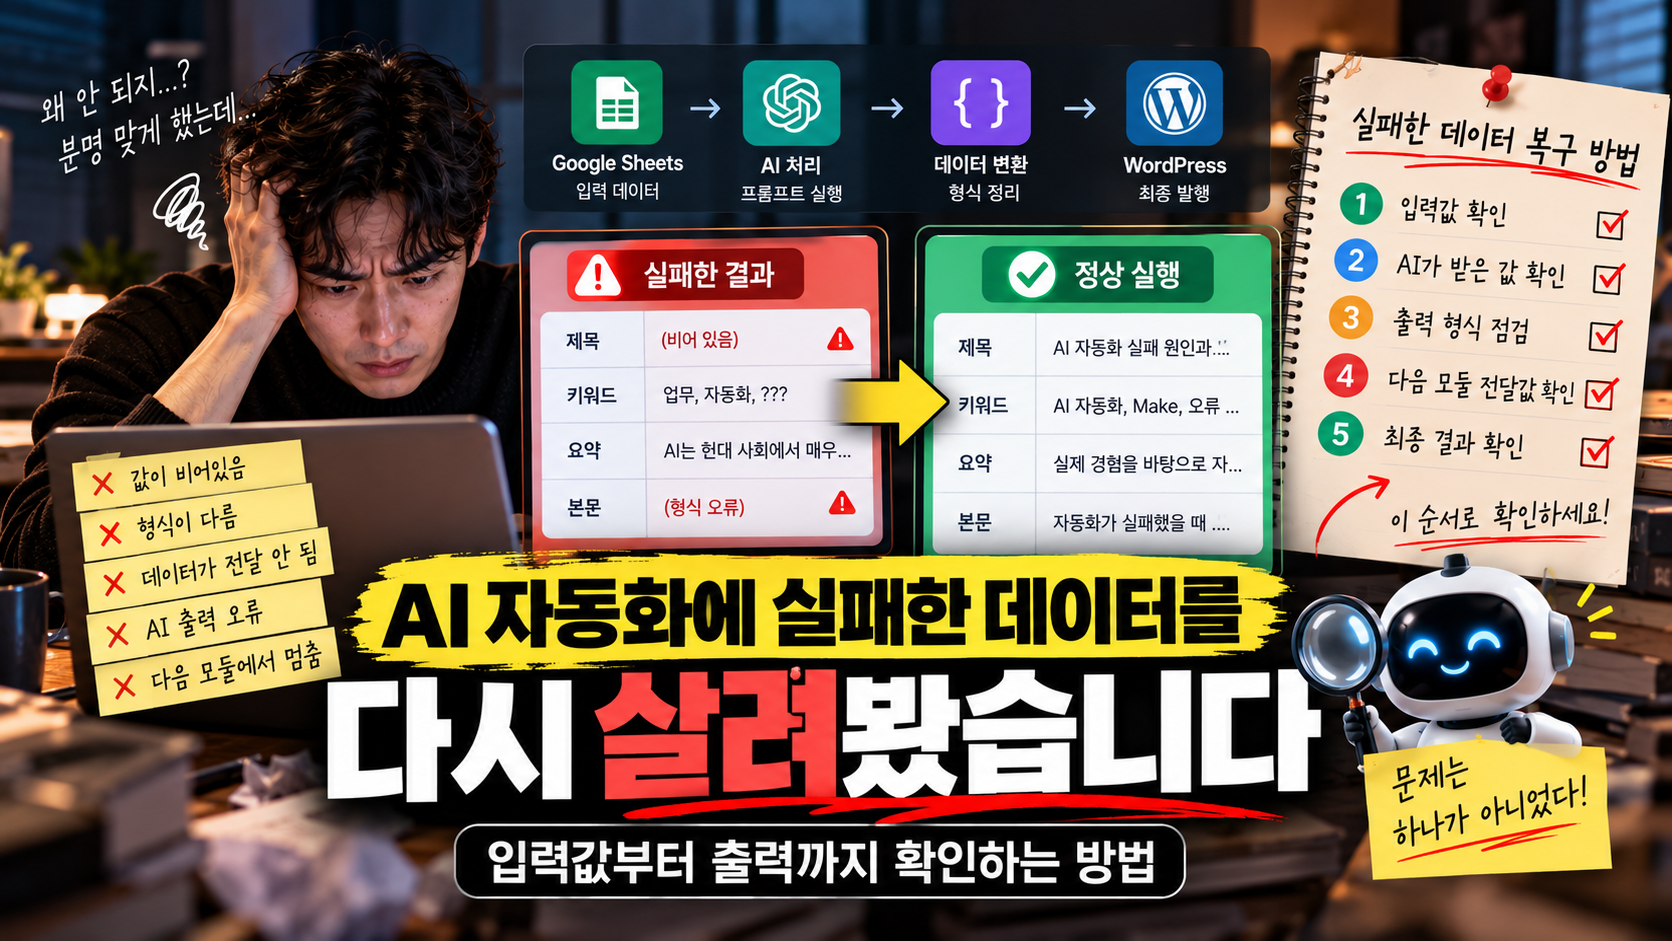
AI 자동화를 처음 만들 때는 결과가 정상적으로 나오면 성공이라고 생각하기 쉽다.
하지만 실제로 Make에서 여러 모듈을 연결해보니 결과가 잘못됐을 때가 더 중요했다.
AI가 잘못 판단한 것인지, 처음 입력된 데이터가 문제였는지, 중간에 데이터가 제대로 전달되지 않은 것인지, 아니면 마지막 단계에서 문제가 발생한 것인지 찾아야 하기 때문이다.
한 번에 여러 단계를 연결해놓으면 어디에서 문제가 발생했는지 찾는 것도 생각보다 쉽지 않았다.
그래서 최근에는 자동화가 실패하면 처음부터 다시 만드는 대신 데이터를 하나씩 거슬러 올라가며 확인하는 방법을 사용하고 있다.
이번 글에서는 실제로 AI 자동화를 만들면서 경험했던 문제를 바탕으로, 실패한 데이터를 어떻게 확인하고 다시 정상적인 흐름으로 돌리는지 정리해보려고 한다.
자동화가 실패했다고 AI가 틀린 것은 아니다
처음에는 결과가 잘못 나오면 AI가 잘못된 답을 만들었다고 생각했다.
하지만 실제로 자동화를 구성해보니 문제의 원인은 여러 곳에 있을 수 있었다.
예를 들어 다음과 같은 구조를 생각해보자.
Google Sheets
↓
AI 처리
↓
결과 정리
↓
Google Sheets 저장
마지막 Google Sheets에 원하는 결과가 나오지 않았다고 해서 반드시 AI가 잘못된 것은 아니다.
처음 입력된 데이터가 비어 있을 수도 있고, AI가 출력한 형식이 다음 단계에서 요구하는 형식과 다를 수도 있다.
또는 모듈은 정상적으로 실행됐지만 다음 단계로 필요한 값이 전달되지 않을 수도 있다.
그래서 오류가 발생하면 가장 먼저 해야 할 일은 “AI가 왜 틀렸지?”라고 생각하는 것이 아니라 어느 단계에서 문제가 시작됐는지 찾는 것이었다.
실제로 겪었던 문제
AI와 Google Sheets를 연결해서 데이터를 처리하는 자동화를 만들면서 입력값과 출력값의 구조가 맞지 않는 문제를 경험했다.
AI가 결과를 만들어내는 것 자체는 가능했지만 다음 단계에서는 결과를 각각의 필드로 사용해야 했다.
예를 들어 다음 단계에서
- 제목
- 핵심 키워드
- 설명
- 본문
을 각각 사용해야 한다면 AI가 하나의 긴 문장으로 결과를 만들어서는 곤란하다.
사람이 보면 내용을 이해할 수 있지만 자동화 시스템은 각각의 값을 구분하지 못할 수 있기 때문이다.
이때 중요한 것은 AI의 결과가 “좋은 문장인가?”만 보는 것이 아니었다.
다음 단계에서 사용할 수 있는 형태인가?
이것까지 확인해야 했다.
그래서 자동화에서 오류가 발생하면 결과 내용뿐 아니라 데이터 구조도 함께 확인하게 됐다.
1단계. 처음 입력값부터 확인한다
자동화가 제대로 작동하지 않았다면 가장 먼저 처음 데이터를 확인한다.
예를 들어 Google Sheets에서 시작했다면 해당 행에 필요한 정보가 실제로 들어 있는지 확인한다.
확인할 내용은 간단하다.
- 값이 비어 있지 않은가?
- 열의 위치가 맞는가?
- 날짜나 숫자의 형식이 바뀌지 않았는가?
- 이전 단계에서 전달하려던 값이 들어왔는가?
- 테스트 데이터 자체에 문제가 없는가?
입력값이 잘못됐는데 AI의 결과만 계속 수정하면 문제가 해결되지 않는다.
자동화에서는 첫 번째 데이터가 이후 모든 단계에 영향을 주기 때문에 시작점부터 확인하는 것이 중요했다.
2단계. AI가 실제로 받은 값을 확인한다
입력값이 정상이라면 다음은 AI 단계다.
여기서는 단순히 AI의 최종 답변만 보는 것이 아니라 AI에게 실제로 어떤 데이터가 전달됐는지 확인하는 것이 중요하다.
예를 들어 내가 Google Sheets에서 특정 셀의 내용을 AI에게 전달했다고 생각했는데 실제 실행 기록을 확인해보니 다른 값이 들어갔다면 AI의 답변이 이상한 것은 당연하다.
이 단계에서는 다음을 확인한다.
| 확인 항목 | 질문 |
|---|---|
| 입력 데이터 | AI에게 원하는 값이 전달됐는가? |
| 지시사항 | 필요한 조건이 모두 들어갔는가? |
| 출력 형식 | 다음 단계에 맞게 지정했는가? |
| 결과 | AI가 입력에 맞는 답을 만들었는가? |
AI의 결과만 보고 판단하면 원인을 놓칠 수 있다.
3단계. AI의 출력 형식을 확인한다
AI 자동화에서 특히 자주 확인해야 하는 부분이다.
사람이 읽기 좋은 결과와 자동화가 처리하기 좋은 결과는 다를 수 있다.
예를 들어 AI가 다음처럼 결과를 만들었다고 하자.
“제목은 AI 자동화이고 핵심 키워드는 업무 자동화입니다. 본문에서는 자동화의 장점을 설명합니다.”
사람이 읽기에는 문제가 없다.
하지만 다음 모듈에서 제목, 키워드, 본문을 각각 사용해야 한다면 데이터를 다시 나누는 과정이 필요하다.
그래서 자동화에서는 처음부터 출력 형식을 명확하게 지정하는 것이 좋다.
예를 들어
제목:
키워드:
설명:
본문:
처럼 각각의 결과를 분리하거나 자동화에서 처리하기 적합한 구조로 만드는 것이다.
4단계. 다음 모듈에 데이터가 제대로 전달됐는지 확인한다
AI의 결과가 정상이라면 이제 다음 단계로 넘어간다.
여기서도 문제가 생길 수 있다.
앞 단계에서는 값이 제대로 나왔는데 다음 모듈에서 해당 값이 비어 있을 수 있다.
이 경우 AI를 다시 수정할 필요가 없다.
문제는 데이터 전달 과정에 있기 때문이다.
실제 Make 작업을 하면서 모듈을 연결하는 과정에서도 이런 구조적인 확인이 필요했다.
처음에는 화면상 연결만 보면 될 것 같았지만 실제로는 어떤 모듈의 결과를 다음 모듈에서 사용하는지 정확하게 확인해야 했다.
그래서 지금은 새로운 모듈을 연결할 때 한 번에 전체 시나리오를 실행하기보다 앞 단계부터 하나씩 테스트한다.
5단계. 마지막 결과를 처음부터 역으로 확인한다
문제가 어디에서 발생했는지 모르겠다면 결과부터 거꾸로 올라가는 방법도 유용하다.
예를 들어 최종 Google Sheets에 잘못된 값이 들어갔다면 다음처럼 확인한다.
최종 결과
↓
바로 앞 모듈의 결과
↓
AI 출력
↓
AI 입력값
↓
처음 데이터
이렇게 한 단계씩 확인하면 어느 지점부터 값이 달라졌는지 찾을 수 있다.
자동화 전체를 다시 실행하는 것보다 훨씬 안전한 방법이다.
실패한 데이터를 바로 다시 실행하면 안 되는 이유
오류가 발생하면 빨리 다시 실행하고 싶어진다.
하지만 외부 AI나 검색 서비스를 사용하는 자동화라면 실행 자체가 사용량이나 비용으로 이어질 수 있다.
실제로 자동화 테스트 과정에서 Web Search를 전체 실행하기 전에 AI Web Search 크레딧이 약 25개 사용될 가능성을 확인한 경험이 있었다.
이때 바로 전체 실행하는 것보다 먼저 작은 데이터 하나로 테스트하는 것이 훨씬 안전하다.
그래서 현재는 다음 순서를 중요하게 생각한다.
문제 확인 → 원인 추적 → 한 건 테스트 → 결과 확인 → 전체 실행
자동화에서는 ‘빨리 다시 실행하는 것’보다 ‘왜 실패했는지 확인하는 것’이 먼저다.
실패한 데이터를 다시 살리는 방법
내가 지금 사용하는 방법을 간단하게 정리하면 다음과 같다.
| 순서 | 확인 내용 |
|---|---|
| 1 | 처음 입력 데이터 확인 |
| 2 | AI에 전달된 실제 값 확인 |
| 3 | AI 결과 확인 |
| 4 | 출력 형식 확인 |
| 5 | 다음 모듈 전달값 확인 |
| 6 | 최종 결과 확인 |
| 7 | 한 건만 다시 테스트 |
| 8 | 정상 확인 후 전체 실행 |
이렇게 하면 자동화 전체를 처음부터 다시 만들 필요가 없다.
문제가 발생한 지점을 찾아 해당 부분만 수정할 수 있기 때문이다.
자동화는 실패하지 않는 것보다 실패를 찾기 쉬운 구조가 중요하다
처음에는 자동화를 만들 때 오류가 발생하지 않도록 만드는 것만 생각했다.
하지만 여러 번 직접 만들어보면서 생각이 조금 바뀌었다.
복잡한 자동화에서는 모든 오류를 사전에 막는 것이 현실적으로 어렵다.
그래서 오류가 발생했을 때 어디에서 문제가 생겼는지 빠르게 확인할 수 있는 구조를 만드는 것이 중요하다.
각 단계의 입력과 출력을 확인할 수 있고, 작은 단위로 테스트할 수 있어야 한다.
그리고 문제가 생겼을 때 전체를 다시 실행하지 않고 특정 단계부터 확인할 수 있어야 한다.
내가 자동화를 만들면서 바꾼 습관
예전에는 자동화를 만들면 전체 흐름을 한 번에 완성하고 실행하려고 했다.
지금은 조금 다르게 접근한다.
먼저 가장 작은 단위로 만든다.
한 건의 데이터를 넣는다.
결과를 확인한다.
문제가 없으면 다음 모듈을 연결한다.
다시 테스트한다.
그리고 마지막에 여러 데이터를 대상으로 실행한다.
이 과정이 처음에는 조금 느리게 느껴질 수 있다.
하지만 오류가 발생했을 때 전체 구조를 다시 살펴보는 시간을 줄여준다.
실패한 자동화도 기록할 가치가 있었다
AI 자동화를 직접 만들어보면서 알게 된 것은 성공한 결과만큼 실패한 과정도 중요하다는 점이다.
어떤 모듈에서 문제가 발생했는지 기록해두면 다음 자동화를 만들 때 같은 실수를 반복하지 않을 수 있다.
특히
- 잘못 연결했던 모듈
- 맞지 않았던 출력 형식
- 누락된 입력값
- 예상과 달랐던 AI 결과
- 전체 실행 전에 확인해야 했던 사용량
같은 내용을 기록해두면 나중에 하나의 체크리스트가 된다.
결국 실패한 데이터는 버려야 할 결과가 아니라 자동화를 개선하기 위한 테스트 데이터가 될 수 있다.
자동화의 목표는 ‘오류 0개’가 아니었다
직접 자동화를 만들어보면서 가장 크게 배운 것은 자동화가 항상 완벽하게 작동해야 한다는 생각을 조금 내려놓는 것이었다.
AI가 포함된 시스템에서는 예상하지 못한 결과가 발생할 수 있다.
중요한 것은 문제가 발생했을 때
어디에서 문제가 시작됐는지 찾고,
작은 테스트로 수정한 뒤,
정상적인 결과를 확인하고,
다시 전체 작업에 적용할 수 있는 구조를 만드는 것이다.
그래서 지금은 새로운 AI 자동화를 만들 때 성공 여부만 기록하지 않는다.
어떤 입력을 사용했는지, 어떤 결과가 나왔는지, 어디에서 오류가 발생했는지까지 함께 확인하려고 한다.
자동화는 한 번 만들어놓고 끝나는 프로그램이라기보다 실제 사용하면서 계속 수정하고 개선하는 작업에 가깝다.
그리고 직접 만들어본 경험을 돌아보면, 좋은 자동화는 처음부터 완벽한 자동화가 아니라 문제가 생겼을 때 원인을 찾고 다시 정상 상태로 돌릴 수 있는 자동화에 더 가깝다고 생각한다.
앞으로 원킹에서도 AI 자동화를 직접 만들면서 성공한 사례뿐 아니라 실패했던 과정과 수정 방법까지 함께 기록해보려고 한다.
그래야 AI 자동화를 처음 시작하는 사람도 단순히 결과만 보는 것이 아니라 실제로 문제가 발생했을 때 어디부터 확인해야 하는지 참고할 수 있기 때문이다.