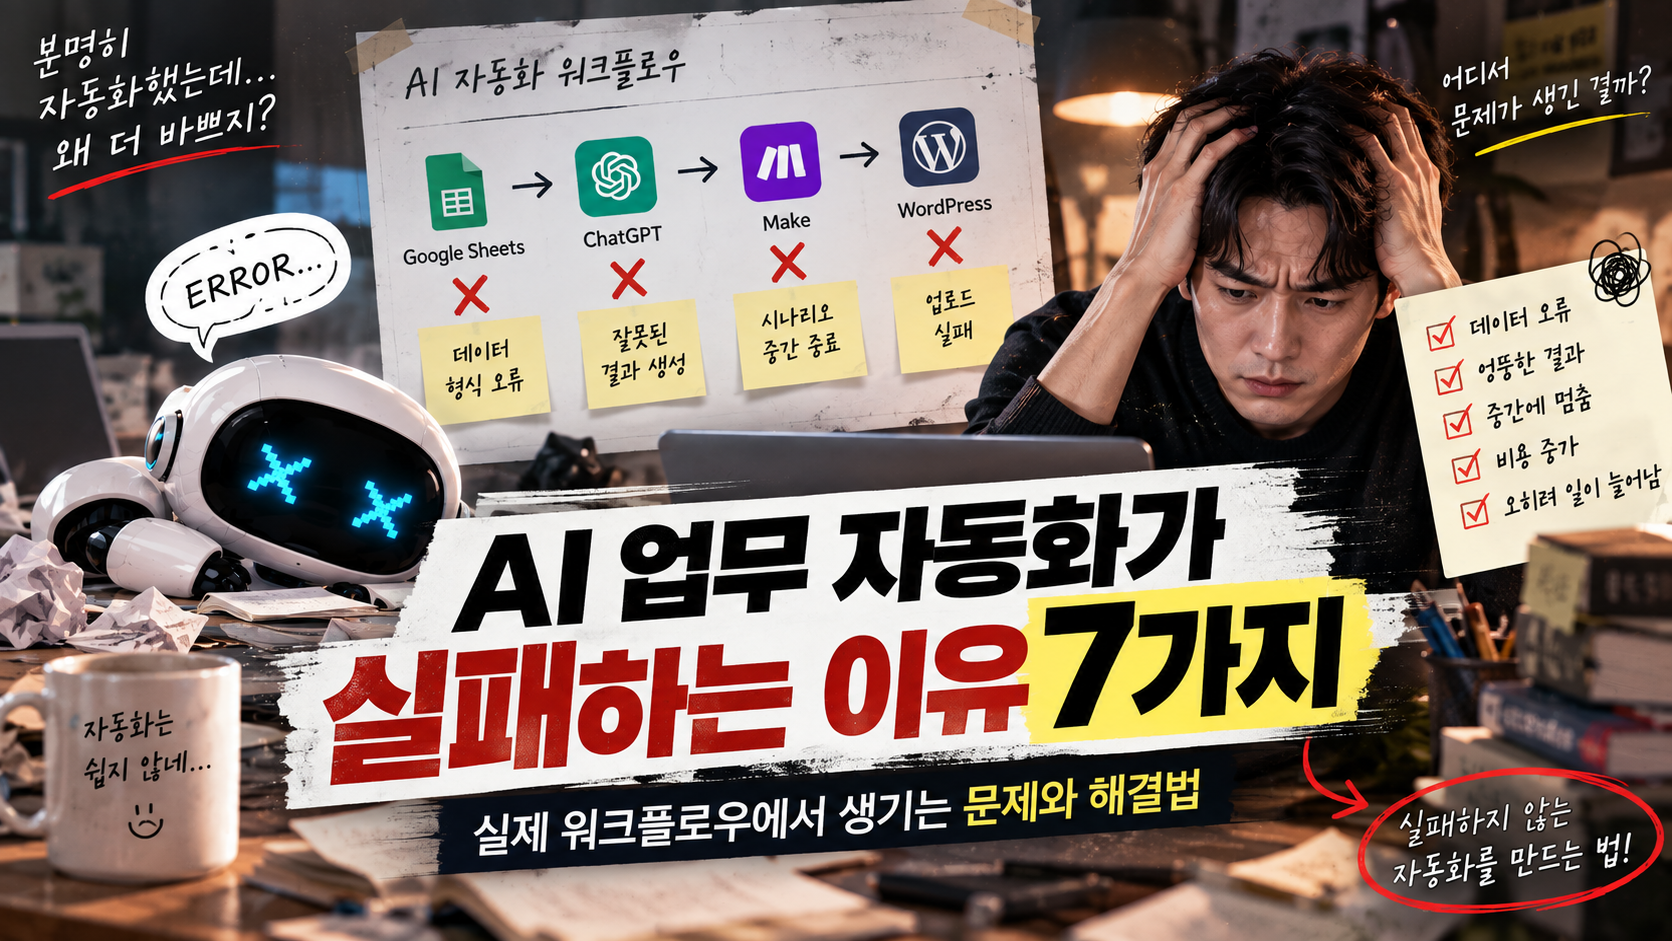
AI 업무 자동화를 처음 만들 때는 기대가 크다.
“이것만 연결하면 이제 알아서 돌아가겠지.”
그런데 막상 실행해보면 생각보다 자주 문제가 생긴다.
AI가 엉뚱한 결과를 내놓기도 하고, 자동화 단계가 중간에서 멈추기도 한다. 심지어 자동화가 잘 돌아가는데도 사람이 확인하고 수정하는 시간이 너무 많이 들어 효율이 떨어지는 경우도 있다.
직접 자동화를 구성하면서 느낀 것은 자동화의 실패가 반드시 AI의 성능 때문만은 아니라는 점이다.
대부분은 구조를 잘못 설계했거나 테스트가 부족해서 발생한다.
1. 처음부터 너무 많은 일을 자동화한다
가장 흔한 실수다.
처음부터
정보 수집 → AI 분석 → 글 작성 → 이미지 생성 → 업로드 → SNS 공유
처럼 모든 과정을 한 번에 연결하려고 한다.
문제는 어디에서 오류가 발생했는지 찾기가 어려워진다는 것이다.
처음에는 한 가지 작업만 자동화하는 것이 좋다.
예를 들어
“새로운 자료가 들어오면 AI가 핵심 내용만 정리한다.”
정도의 작은 자동화부터 시작한다.
정상적으로 작동하는 것을 확인한 뒤 다음 단계를 추가하는 방식이 훨씬 안정적이다.
2. AI에게 너무 많은 판단을 맡긴다
AI는 문서를 분류하거나 내용을 정리하는 데 상당히 유용하다.
하지만 기준이 모호한 상태에서 모든 판단을 AI에게 맡기면 결과가 일정하지 않을 수 있다.
예를 들어
“좋은 상품이면 등록해줘.”
라고 하는 것보다
“가격이 5만원 이하이고, 리뷰가 1,000개 이상이며, 평점이 4.5 이상인 경우 등록 대상으로 분류한다.”
처럼 판단 기준을 구체적으로 정하는 편이 좋다.
AI에게 자유를 주는 것과 기준 없이 맡기는 것은 전혀 다른 이야기다.
3. 데이터 형식이 맞지 않는다
AI 자동화에서 의외로 자주 발생하는 문제가 데이터 연결이다.
앞 단계에서는
상품명 / 가격 / 링크
형태로 데이터를 보냈는데 다음 단계에서는
상품명 / 설명 / 이미지 / 가격 / 링크
를 요구한다면 문제가 생길 수 있다.
사람이 보면 쉽게 이해할 수 있는 정보라도 자동화 시스템에서는 입력값의 형식이 맞아야 한다.
따라서 각 단계마다
“무엇을 입력받고, 무엇을 출력하는가?”
를 먼저 확인하는 것이 중요하다.
4. 테스트 없이 전체 실행한다
자동화가 만들어졌다고 바로 전체 데이터를 넣는 것도 위험하다.
특히 AI를 사용하는 자동화는 실행 횟수에 따라 비용이 발생할 수 있기 때문에 더욱 그렇다.
처음에는 테스트용 데이터 1~2개만 넣어보는 것이 좋다.
예를 들어
1개 실행 → 결과 확인 → 문제 수정 → 5개 실행 → 다시 확인 → 전체 실행
순서로 진행하면 문제가 생겨도 원인을 찾기 쉽다.
실제로 자동화를 만들면서 “이제 됐겠지”라는 생각으로 바로 실행하는 것보다 작은 데이터로 먼저 확인하는 것이 훨씬 안전했다.
5. 실제로 만들어본 자동화에서 생긴 문제
직접 구성했던 자동화 중에는 상품이나 자료를 수집한 뒤 AI로 내용을 정리하고, 결과를 Google Sheets에 저장하는 흐름이 있었다.
처음에는 상당히 단순해 보였다.
새로운 데이터가 들어온다.
→ AI가 내용을 분석한다.
→ 필요한 항목을 정리한다.
→ Google Sheets에 한 줄로 저장한다.
그런데 실제로 연결해보니 AI가 만들어낸 결과의 형식이 예상과 다르게 나오는 문제가 생길 수 있었다.
예를 들어 Google Sheets에는
상품명 / 가격 / 설명 / 링크
를 각각 다른 칸에 넣어야 하는데 AI가 하나의 긴 문장으로 결과를 만들어버리면 다음 단계에서 데이터를 제대로 나누기 어려워진다.
결국 문제는 AI가 글을 못 써서가 아니라 ‘다음 단계가 원하는 데이터 형식’을 처음부터 명확하게 정하지 않았다는 데 있었다.
그래서 자동화를 만들 때 AI에게 단순히
“상품 정보를 정리해줘.”
라고 지시하는 것보다
“상품명, 가격, 설명, 링크를 각각 별도의 항목으로 출력해줘.”
처럼 출력 구조를 명확하게 지정하는 것이 중요했다.
그리고 처음부터 전체 데이터를 실행하지 않고 테스트 데이터 하나를 넣어 결과를 확인한 뒤 다음 단계로 넘어가는 것이 훨씬 안전했다.
이런 경험을 통해 알게 된 것은 자동화에서 가장 중요한 것 중 하나가 ‘각 단계 사이의 약속’이라는 점이다.
앞 단계가 무엇을 만들어서 넘길지, 다음 단계가 무엇을 받아야 하는지를 명확하게 정해야 한다.
6. AI가 만든 결과를 검증하지 않는다
AI가 그럴듯하게 작성했다고 해서 반드시 정확한 것은 아니다.
특히 가격, 날짜, 수량, 정책, 제품 정보처럼 정확성이 중요한 데이터는 별도의 검증 과정이 필요하다.
가장 간단한 방법은 AI가 결과를 만든 뒤
“원본 데이터와 비교”
하는 단계를 추가하는 것이다.
필요하다면 사람이 최종 결과를 확인한 뒤 다음 단계로 넘어가도록 설계할 수도 있다.
7. 오류가 발생했을 때 어디서 멈췄는지 모른다

자동화가 여러 단계로 길어질수록 오류를 추적하기 어려워진다.
예를 들어
자료 수집 → AI 분석 → 데이터 저장 → 이메일 발송
이라는 자동화가 있다면 이메일이 발송되지 않았을 때 원인이 이메일 단계인지, 데이터 저장 단계인지, AI 분석 단계인지 확인해야 한다.
그래서 각 단계의 결과를 확인할 수 있도록 만들고, 중요한 단계에는 오류 처리나 재시도 방법을 준비하는 것이 좋다.
자동화는 “실패하지 않는 시스템”보다 “실패했을 때 원인을 쉽게 찾을 수 있는 시스템”이 더 현실적이다.
8. 자동화 비용보다 사람이 확인하는 시간이 더 많이 든다
이 부분은 27번에서 이야기한 ROI와도 연결된다.
자동화가 정상적으로 실행되더라도 사람이 매번 결과를 20분씩 확인해야 한다면 생각보다 효율이 낮을 수 있다.
예를 들어 자동화 자체는 1분 만에 끝났지만 사람이 결과를 수정하는 데 15분이 걸린다면 실제 절약시간은 14분에 불과하다.
따라서 자동화 후에는 반드시
“자동화가 몇 분 빨라졌는가?”
뿐만 아니라
“사람이 얼마나 덜 일하게 되었는가?”
를 봐야 한다.
자동화가 실패했을 때 확인할 순서
문제가 생겼다면 무작정 전체 구조를 뜯어고치기보다 다음 순서로 확인해보는 것을 추천한다.
| 확인 순서 | 질문 |
|---|---|
| 1 | 입력 데이터가 제대로 들어왔는가? |
| 2 | AI가 올바른 결과를 만들었는가? |
| 3 | 다음 단계로 데이터가 정상적으로 전달됐는가? |
| 4 | 조건이나 필터가 의도대로 작동했는가? |
| 5 | 외부 서비스의 오류는 없는가? |
| 6 | 사람이 결과를 확인하는 과정에서 문제가 생겼는가? |
| 7 | 전체 실행 전에 충분히 테스트했는가? |
이렇게 하나씩 확인하면 문제의 범위를 빠르게 좁힐 수 있다.
결국 좋은 자동화는 한 번에 완벽하게 만드는 것이 아니다.
작게 만들고, 테스트하고, 실패한 부분을 수정하고, 다시 실행하는 과정을 반복하면서 안정성을 높이는 것이다.
특히 AI 자동화에서는 AI에게 모든 것을 맡기는 것보다
“어떤 부분은 AI가 판단하고, 어떤 부분은 정해진 규칙으로 처리하며, 어떤 부분은 사람이 확인할 것인가”
를 나누는 것이 중요하다.
자동화가 실패했다고 해서 자동화 자체가 나쁜 것은 아니다.
오히려 실패한 지점을 찾아내면 다음 자동화를 훨씬 잘 설계할 수 있다.
그래서 자동화를 시작할 때 가장 먼저 준비해야 할 것은 거창한 AI 기술이 아니라 작은 테스트 하나일지도 모른다.